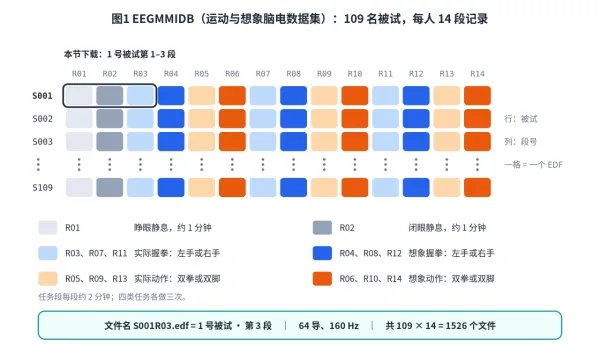
一、认识 EEGMMIDB(运动与想象脑电数据集):后面每一节都用它
●规模:109 名被试,64 导,采样率 160 Hz,在 PhysioNet 上公开下载。
●每人 14 段记录:第 1、2 段是睁眼、闭眼静息,各约 1 分钟;其余 12 段是四类任务(实际握拳、想象握拳、实际双拳或双脚、想象双拳或双脚)各做三次,每段约 2 分钟。
●文件名就是索引:S001R03.edf 即 1 号被试第 3 段。要分析哪些被试、哪些段,在脚本里就是两个数字列表。
●为什么全程用它:被试多,按被试划分来验证才有意义;有运动想象段,ERD、CSP、分类都能直接用;MNE 一个函数就能下载。
●本节下载 1 号被试第 1–3 段:两段静息加一段握拳任务,接下来浏览波形、看功率谱都接着用。
二、一段提示词:写读取脚本
●新开一个 AI 对话,打开上一节建好的项目文件夹。提示词末尾写明用项目里的独立环境运行,换了对话也不会用错环境。
提示词:
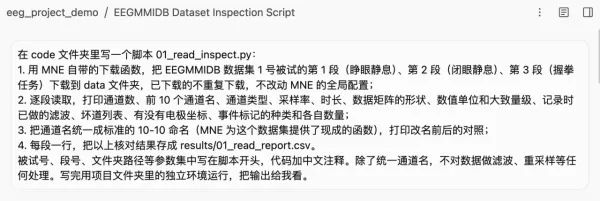
在 code 文件夹里写一个脚本 01_read_inspect.py:
1. 用 MNE 自带的下载函数,把 EEGMMIDB 数据集 1 号被试的第 1 段(睁眼静息)、第 2 段(闭眼静息)、第 3 段(握拳任务)下载到 data 文件夹,已下载的不重复下载,不改动 MNE 的全局配置;
2. 逐段读取,打印通道数、前 10 个通道名、通道类型、采样率、时长、数据矩阵的形状、数值单位和大致量级、记录时已做的滤波、坏道列表、有没有电极坐标、事件标记的种类和各自数量;
3. 把通道名统一成标准的 10-10 命名(MNE 为这个数据集提供了现成的函数),打印改名前后的对照;
4. 每段一行,把以上核对结果存成 results/01_read_report.csv。
被试号、段号、文件夹路径等参数集中写在脚本开头,代码加中文注释。除了统一通道名,不对数据做滤波、重采样等任何处理。写完用项目文件夹里的独立环境运行,把输出给我看。
每条要求的用意:
要求
为什么这样写
写明被试号和段号
文件按"被试 + 段号"命名,写清楚 AI 才不会多下或下错
已下载的不重复下载
第 3 段上一节已经下过;以后批量下载上百个文件,这一条省时间也省流量
不改动 MNE 的全局配置
下载函数默认会询问是否把下载位置写进 MNE 的全局设置,在 AI 后台运行时可能卡住或报错;数据位置由脚本参数决定
逐段打印各项信息
每一项都是后面要用的参数,读进来先核对,比做到一半才发现不对省事
统一通道名并打印对照
原始通道名不是标准写法,不统一,后面装电极坐标、按名字取通道都会失败;打印对照便于核对
结果存成 CSV
核对记录留档;以后检查所有被试,也是一人一段一行
除统一通道名外不做处理
读取这一步只管读;滤波、重参考等各自单独做、单独验收
用独立环境运行
新开的对话也不会用错 Python 环境
① 发出提示词
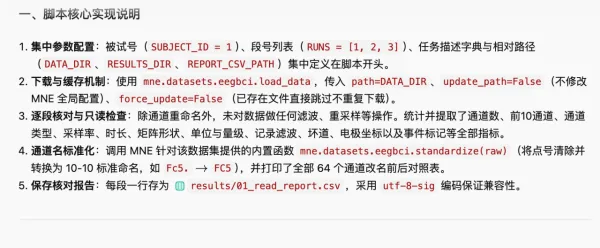
② AI 说明脚本的实现
三、读进来是什么:Raw 对象
●MNE 读进来的是一个 Raw 对象,装着三样东西:数据矩阵(通道× 时间点)、info(采样率、通道名、滤波等说明)、annotations(事件标记)。第 1 节说的"通道 × 时间"矩阵就在里面。
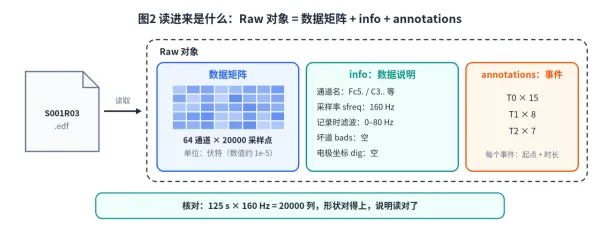
●info 里几项要换成数据的眼光看:
○采样率 160 Hz:一秒 160 列;能分析的频率上限是它的一半,80 Hz。
○记录时滤波 0–80 Hz:上限 80 Hz 就是采样率的一半;下限 0 表示没做高通,波形会带慢漂移,到滤波那一步再处理。
○坏道 bads 为空:坏道还没标,下一节浏览波形时标。
○电极坐标 dig 为空:文件里只有通道名,没有坐标。坐标要拿通道名去标准电极位置表里查,所以通道名必须写对。
●通道名不标准:原始文件把每个名字用点号补齐到 4 个字符,大小写也不规范,如 Fc5.、C3..、Cpz.。医生一眼看得懂,程序却按名字逐字匹配:装电极坐标时 64 个通道一个也对不上,脚本里写 C3 也取不到 C3..。所以读进来先统一成标准写法(FC5、C3、CPz)。改的只是通道名,数据本身不变。
●单位是伏特:EDF 文件里存的是微伏,MNE 读进来一律换成伏特,所以数值在 1e-5 量级,也就是几十微伏。以后写幅度阈值、设显示刻度都按伏特,比如 100 µV 写成 100e-6。
●先读文件头,用时再加载:不加载时 MNE 只读文件头,约 64 KB;加载后才是完整矩阵,第 3 段约 10 MB,比文件大约 4 倍(文件里存的是整数,内存里是高精度小数)。109 名被试的全部数据一起加载约 14 GB,所以批量处理时逐个读、逐个处理。
四、验收:看代码,看输出
看代码:
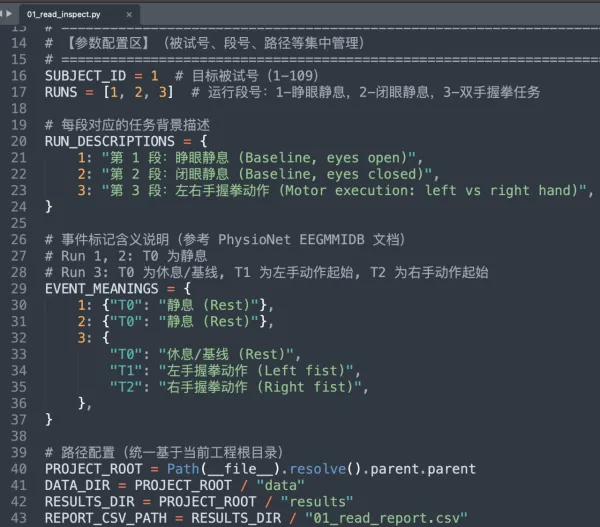
③ 脚本开头的参数区
●参数区:被试号 1,段号 1、2、3,data、results 的路径,和要求一致。
●有没有自作主张:读取之后有没有多出滤波、重采样、删通道之类的步骤。读取这一步不该改动数据。
●通道名怎么统一的:用的是 MNE 的现成函数,还是 AI 自己写的替换规则。自己写的,要对照下面的改名对照逐个核对。
●看不懂的地方,让 AI 逐段解释。
看输出:
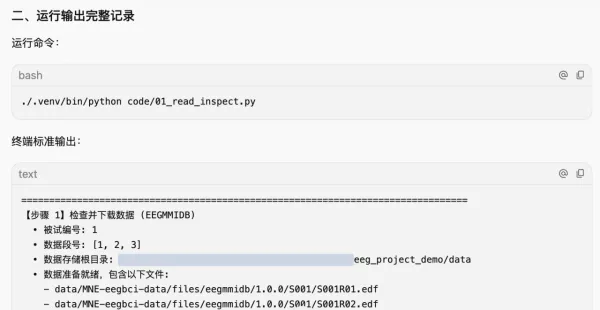
④ 用独立环境运行,数据下载就绪
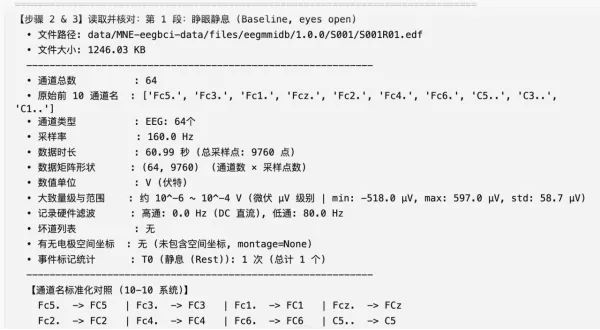
⑤ 第 1 段(睁眼静息)的核对信息
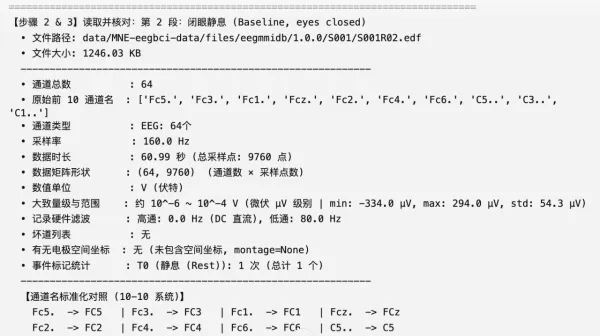
⑥ 第 2 段(闭眼静息)的核对信息
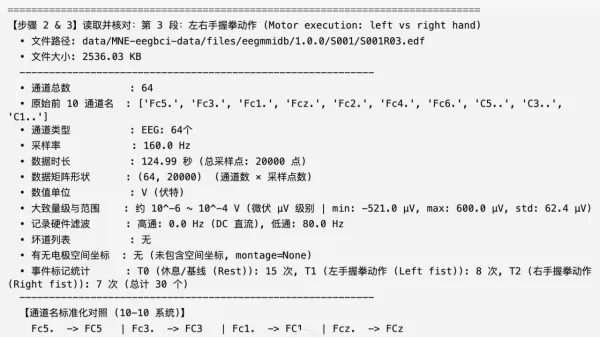
⑦ 第 3 段(握拳任务)的核对信息
参考答案:
项目
第 1 段 睁眼静息
第 2 段 闭眼静息
第 3 段 握拳任务
通道数 / 类型
64,均为 EEG
64,均为 EEG
64,均为 EEG
采样率
160 Hz
160 Hz
160 Hz
时长
61 s
61 s
125 s
矩阵形状
64 × 9760
64 × 9760
64 × 20000
数值量级
约 1e-5(伏特)
约 1e-5(伏特)
约 1e-5(伏特)
记录时滤波
0–80 Hz
0–80 Hz
0–80 Hz
坏道 / 电极坐标
无 / 无
无 / 无
无 / 无
事件
T0 × 1
T0 × 1
T0 × 15、T1 × 8、T2 × 7
●形状对公式:时长× 采样率 = 列数(61 × 160 = 9760,125 × 160 = 20000)。对得上,说明读对了。
●数值约 1e-5:单位是伏特,正常。如果看到几十、几百,说明单位没换算对,后面所有阈值都会跟着错。
●64 个通道全是 EEG:没有单独的眼电通道,眨眼只能从额极通道上看。
●事件:静息段只有一个 T0,标着整段静息;任务段 T0、T1、T2 交替出现,共 30 个。各自的含义在讲事件标记时展开。
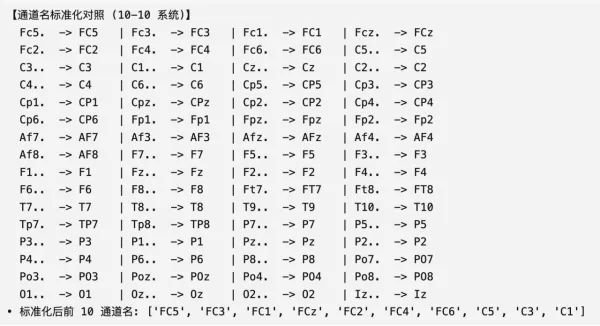
⑧ 通道名改名前后对照
●改名对照:64 个通道都改了。规则只有三条:去掉点号;区域字母大写,中线的 z 小写;Fp 保持原样。
原始名
标准名
原始名
标准名
Fc5.
FC5
Fp1.
Fp1
C3..
C3
Af7.
AF7
Cpz.
CPz
T10.
T10
⑨ 核对结果存入 CSV

⑩ 生成的 01_read_report.csv(节选)
●核对记录:01_read_report.csv 里三段各占一行,数值与上面的参考答案一致。
●论文方法可以这样写:数据来自 PhysioNet 公开数据库的 EEG Motor Movement/Imagery Dataset(Schalk 等,2004;Goldberger 等,2000),64 导,采样率 160 Hz;通道名按国际 10-10 系统统一命名。
五、本节留下的文件
位置
内容
code/
01_read_inspect.py:下载、读取、核对脚本(新增)
data/
EEGMMIDB 1 号被试第 1–3 段原始 EDF(第 3 段上一节已下载)
results/
01_read_report.csv:三段数据的核对记录
●原始 EDF 不做任何改动。统一通道名只在脚本运行时生效,之后每个脚本读完数据,都先统一一次通道名。