原问题
MR的DICOM数据经过数据格式转换、N4矫正,我下一步应该进行标准化还是归一化是不是选一个就可以?
问题梳理
做MR相关研究时,对原始DICOM格式影像通常要做哪些预处理?作用分别是什么?
AI回答
做 MR 研究时,预处理的根本目的可以概括成一句话:MR 的原始信号强度是任意单位(不像 CT 有 HU 这样的绝对标度),几何上常是各向异性厚层,而且天生带着射频不均匀、运动和磁敏感失真。预处理就是把"设备相关的原始数据"变成"跨受试者、跨中心、跨时间点可比的标准化图像"。下面按通常的执行顺序说明。
一、数据整理与质量控制
去标识化(de-identification):DICOM 头里含大量 PHI(姓名、住院号、生日、机构、甚至 3D 序列可重建面部)。去标识时要保留研究必需的采集参数,删除或替换身份字段;涉及头颅高分辨序列还需考虑 defacing。
序列筛选与归类:一次检查往往有几十个 series。需要依据 SeriesDescription 和实际采集参数(TR/TE/翻转角/是否加脂肪抑制/是否增强)判断真实模态,剔除定位像、重复扫描、失败序列。实践中 SeriesDescription 极不可靠(同一序列在不同机器上叫法完全不同),所以判定应以参数为主、描述为辅。
质量评估:主观评分(运动伪影、金属伪影、卷褶、信号丢失)加客观指标(SNR、CNR、CJV 等)。这一步的意义不只是"剔除坏图",而是必须留下记录——最终论文里要能说清入组多少例、因何剔除多少例,否则审稿人会质疑选择偏倚。
格式转换(DICOM → NIfTI):DICOM 是以切片为单位的 2D 集合,元数据分散;NIfTI 以体积为单位并携带完整的 affine 矩阵,几乎所有分析工具链都以它为输入。常用 dcm2niix,同时会导出 JSON 侧车文件和扩散序列的 bval/bvec。转换环节最容易出的错是方向信息丢失或左右翻转,因此转换后应统一重定向到标准坐标(如 RAS),并抽样做视觉核对——左右搞反在临床研究里是致命错误。
二、几何与空间层面的校正
偏置场校正(bias field correction,N4ITK):射频线圈的接收不均匀会让同一组织在图像中心和边缘呈现不同灰度,形成低频强度漂移。这对任何基于强度的分割、纹理分析、放射组学都是系统性干扰,是 MR 特有且几乎必做的一步。
去颅骨 / ROI 裁剪(skull stripping):去掉颅骨、皮下脂肪、颈部等无关结构,一方面减少后续配准和强度归一化被无关信号污染,另一方面大幅降低计算量。脑 MR 上 HD-BET、SynthStrip 比传统 BET 稳健得多。注意它与 N4 存在相互依赖,规范做法是"粗略 N4 → 生成脑掩膜 → 掩膜内精细 N4″迭代一次。
去噪(denoising):MR 噪声服从 Rician 分布而非高斯,常用 NLM、扩散数据上的 MP-PCA。要留意权衡:去噪提高 SNR 有利于分割,但会平滑高频纹理,做放射组学时可能反而损失有判别力的特征,是否做需要在验证集上比较。
重采样到各向同性体素:临床序列层厚常 3–5 mm 而层内 0.5 mm,这种各向异性会让 3D 纹理特征和 3D 卷积核在不同方向上"看到"不同尺度的信息。因此通常重采样到 1×1×1 mm 之类的等向体素。关键细节:图像用 B 样条/线性插值,标签掩膜必须用最近邻,否则会产生不存在的中间标签值。
失真校正:EPI 类序列(DWI、fMRI)的磁敏感失真、涡流形变、梯度非线性,需要 fieldmap/反相位编码(topup)与 eddy 类工具校正。不校正就直接把 DWI 与结构像叠加分析,解剖对应关系是错的。
配准(registration):分几个层次——同一受试者多模态间的刚性共配准(把 T1、T2、FLAIR、DWI 对齐到同一空间,才能做多通道输入);到标准模板(MNI 等)的仿射或非线性配准,用于群体比较和空间先验;纵向随访配准,建议配到"中间空间"以避免只对随访图插值造成的偏倚;以及动态/功能序列的运动校正。原则是尽量减少插值次数,把多步变换合成一个变换场一次性应用。
三、强度标准化与多中心谐调
这是 MR 相对于 CT 最需要额外处理的环节。同一台机器、同一患者、隔天扫描的两幅 T1 灰度值都可能整体偏移,跨中心差异更大。常用做法有脑内体素 z-score、白质参考归一化(WhiteStripe)、Nyúl 直方图分位数匹配、1–99 百分位截断后线性缩放。选哪种取决于任务:需要保留组织间相对对比时倾向直方图匹配,做深度学习输入时 z-score 通常够用。
一个重要例外:ADC 图、T1/T2 mapping、MTR 等定量图本身有物理单位和生物学意义,不应做强度归一化,只做必要的离群值裁剪。
若涉及多中心/多机型,还需要谐调(harmonization) 处理批次效应,可以在图像域(风格迁移、SynthSR 类方法)或特征域(ComBat)进行。这一步必须在划分训练/测试集之后、或用不泄漏标签的方式实施,否则会引入数据泄漏。
四、标注与掩膜处理
ROI 勾画的一致性直接决定研究上限,应报告观察者内/间一致性(Dice、ICC)。掩膜生成后通常还要做形态学处理:保留最大连通域、填洞、边界向内腐蚀 1–2 体素以减轻部分容积效应的影响。
五、建模前的最后一步
放射组学方向需要按 IBSI 规范确定灰度离散化方式(固定 bin 宽度还是固定 bin 数量)——这一参数对特征值影响极大,必须报告。深度学习方向则涉及裁剪/填充到固定尺寸、多模态通道堆叠、patch 采样策略,以及 MR 特异的数据增强(模拟偏置场、运动伪影、ghosting,TorchIO 提供了这类变换)。数据划分务必以患者为单位而非切片为单位,并尽量保留一个独立中心作外部验证。
推荐执行顺序与常见坑
典型流程:DICOM 整理与去标识 → 转 NIfTI → 重定向 → 质控 →(去噪)→ 粗 N4 → 去颅骨/ROI 掩膜 → 精细 N4 → 重采样 → 多模态共配准(必要时到模板)→ 掩膜内强度归一化 → 谐调 → 特征提取或喂入模型。
几个最常见的错误:强度归一化放在去颅骨之前(颅骨脂肪的高信号会污染统计量);掩膜用了线性插值;对 ADC 做了 z-score;配准反复插值导致图像被平滑;以及没有把预处理参数与工具版本固定下来(建议按 BIDS 组织数据并容器化整条管线,否则半年后结果无法复现)。
追加提问
推荐使用什么工具或软件?
AI回答
先给论:一套够用的默认组合
如果不想纠结,脑 MR 用这条链就能覆盖 90% 的研究需求:dcm2niix → HD-BET 或 SynthStrip → ANTs(N4 + 配准)→ intensity-normalization → ITK-SNAP / nnU-Net 标注 → PyRadiomics 或 MONAI,全部用 Python 脚本串起来,装进 Docker。体部 MR(肾、肝、前列腺)把去颅骨换成手工/自动 ROI,去掉模板配准,其余不变。
下面说各环节的具体选择和理由。
DICOM 层
dcm2niix 是转换环节的事实标准,没有替代品——它对各厂商私有标签的处理最完善,会自动导出 bval/bvec 和 BIDS 风格的 JSON 侧车文件。批量整理可以配合 dicomsort,需要精细读写头文件时用 pydicom(Python,最灵活)或 DCMTK(命令行,功能最全)。
去标识化不建议自己写正则,漏字段的风险太高。推荐 RSNA 的 CTP(Clinical Trial Processor) 或 Python 的 dicomanonymizer 包,头颅高分辨序列再加一步去面容(pydeface 或 FreeSurfer 的 mri_deface)。
要按 BIDS 规范组织数据的话,dcm2bids(配置文件驱动,容易上手)或 HeuDiConv(更灵活,学习曲线陡)。这一步看起来是多余的形式主义,但它是后面所有 BIDS-App 一键运行的前提,做群体研究非常值得。
质控与看图
自动质控用 MRIQC,它输出定量的图像质量指标(SNR、CNR、CJV、EFC 等)和逐例可视化 HTML 报告,可以直接作为剔除标准的依据写进论文。
看图/交互检查:ITK-SNAP 最轻量,临床医生半小时就能学会,手动勾画 ROI 首选;3D Slicer 功能最全(Segment Editor、内置 Python 控制台、大量插件),适合复杂任务;FSLeyes 适合快速叠加检查配准结果。
核心处理工具包
ANTs / ANTsPy 是我最推荐的一个。它的 N4BiasFieldCorrection 是偏置场校正的公认最佳实现,antsRegistration 的 SyN 非线性配准精度在多项独立评测中领先。缺点是慢,日常可以用 antsRegistrationSyNQuick。Python 用户直接用 ANTsPy,不必碰命令行。
FSL 强项在扩散和功能数据的失真校正——topup、eddy 基本没有替代品。注意它对商业用途有 license 限制。
FreeSurfer 除了皮层重建,近年更值得用的是两个独立小工具:SynthStrip(任意对比度的通用去颅骨,比 BET 稳健得多)和 SynthSeg(不管什么序列、什么分辨率都能做脑结构分割)。想要速度的话 FastSurfer 是深度学习版本,快约两个数量级。
SPM12 + CAT12 在 VBM 类形态学分析上生态最成熟,但依赖 MATLAB。AFNI 偏 fMRI。MRtrix3 做扩散预处理(dwidenoise 的 MP-PCA 去噪是当前最好的方法之一)。自己搭管线的底层库用 SimpleITK + nibabel 就够。
去颅骨如果是病灶脑(肿瘤、术后、大面积水肿),一定用 HD-BET 或 SynthStrip,FSL BET 在这类图像上失败率高得离谱。脑肿瘤研究可以直接用现成的整合管线 BraTS Toolkit 或 BrainLes preprocessing,把转换、共配准、去颅骨、N4 打包好了。
分割与标注
手工勾画 ITK-SNAP,复杂多标签用 3D Slicer。自动分割现在没什么争议——nnU-Net 是 baseline,它自动配置网络和预处理参数,几乎不用调参,性能常常还能打赢精心调过的自定义模型;MONAI Label 提供人在环路的交互式标注,可以和 Slicer 联动,标注量大时效率提升明显。体部 MR 可以先试 TotalSegmentator MRI 拿到器官掩膜再人工修正。
强度归一化与谐调
Python 的 intensity-normalization 包一站式提供了 z-score、WhiteStripe、Nyúl 直方图匹配、FCM、KDE 等方法,接口统一,方便在验证集上横向比较哪种适合你的任务。多中心谐调用 neuroHarmonize 或 neuroCombat(ComBat 家族)。
特征提取与建模
放射组学用 PyRadiomics(生态最好、文档最全,但要注意它只是部分 IBSI 合规,必须完整报告 bin 宽度、重采样等参数)。对 IBSI 合规度要求高的可以用 MIRP 或 LIFEx(GUI,不写代码也能做)。
深度学习首选 MONAI——它是医学影像专用的 PyTorch 框架,读写 NIfTI、patch 采样、滑窗推理这些轮子都造好了。数据增强务必配 TorchIO,它提供 MR 特异的物理仿真增强(随机偏置场、运动伪影、ghosting、spike),比通用的旋转翻转有意义得多,在小样本上提升很实在。
功能与扩散数据:别自己拼
如果做的是 fMRI 或 DWI,直接用 fMRIPrep / QSIPrep。这两个是容器化的 BIDS-App,输入 BIDS 数据集、一条命令跑完,内部整合了最佳实践并自动生成质控报告。自己用 FSL+ANTs 手搭一遍功能预处理,几乎必然比它做得差,而且没法说服审稿人。
一张对照表
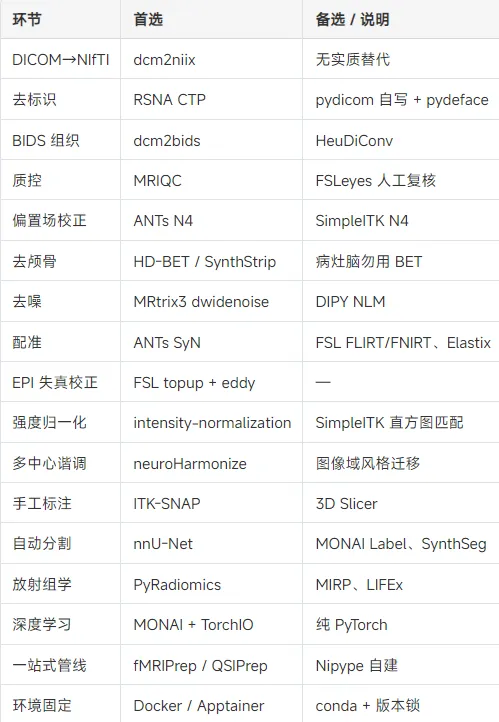
两个容易忽略的实务问题
一是坐标约定不一致。FSL、SPM、ANTs、ITK 对方向和原点的处理约定不同,混用时最容易在配准环节静默出错——图能跑完,结果是错的。稳妥做法是每换一次工具就抽样叠加显示一次,并且把主链路尽量收敛到一个工具包内。
二是版本漂移。同一个 N4 或 nnU-Net,不同版本的默认参数会变,半年后重跑对不上数是很常见的事。用 Docker/Apptainer 把整条管线连版本号一起固定下来,比任何文档都可靠。